2019 · Fintech · Лід · Australian fintech (NDA)
Порятунок постачання у fintech-CRM
Python-CRM для австралійського fintech, де регресії постійно доходили до продакшну. Виправив те, як вносяться зміни, а не переписав те, з чого вони зроблені.
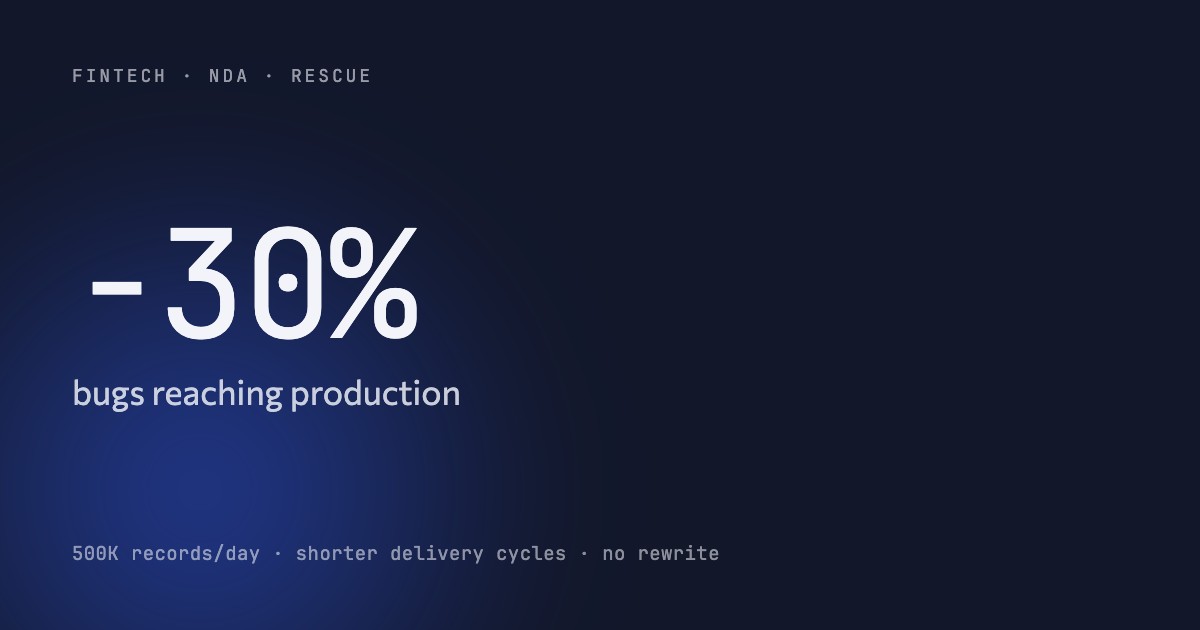
Багів менше на ~30%, цикли постачання коротші, і синхронізація 500K записів на добу, яку платформа витримала
Context
Python-CRM для австралійського fintech — управління клієнтами, автентифікація й авторизація, гранульовані права і фінансові потоки даних під усім цим. Вона працювала, мала реальних користувачів і ставала все гіршою для змін.
Симптомом були регресії. Робота, завершена місяці тому, ламалася, коли торкалися чогось поруч, і це знаходили в продакшні, а не до релізу — іноді клієнт. Кожна коштувала двічі: виправлення і втрачена довіра до тієї частини системи, з якої вона прийшла. Команда, яку кілька разів вкусили, починає обходити код, що кусає, — і саме це обходження тихо перетворює робочу систему на легасі.
Паралельно платформа мусила поглинути більше: синхронізацію фінансових даних через сторонні інтеграції в обсязі, якого наявний спосіб роботи не витримував.
Рішення
Обрав Підтягнути те, як вносяться зміни, поки платформа продовжує випускати фічі замість зупинити постачання й переписати частини, що постійно ламалися
Проблемою був не код, а відсутність будь-чого, що ловить помилки. Переписування дало б свіжу кодову базу з тими самими звичками навколо неї і витратило б місяці, за які клієнт не отримав би нічого. Виправлення процесу неефектне, працює на системі, яка вже є, і починає повертати вкладене першого ж тижня.
Обрав Автотести на шляхах, що рухають гроші, перед усім іншим замість рухатися до широкого покриття по всій кодовій базі
Покриття як число — поганий орієнтир: його найшвидше набирають на коді, який найменше важить. Платежі, фінансові інтеграції та перевірки прав — те, де регресія коштує клієнту реальних грошей або відкриває дані іншого клієнта. Ці шляхи варті непропорційної частки сил, а решта могла почекати.
Обрав Процес релізу, однаковий кожного разу, і рев'ю, за яким щось стоїть замість покладатися на уважність і досвід того, хто саме релізить
Уважність не масштабується й не виживає в дедлайні. Команді, яка росла на цьому акаунті, потрібен був стандарт, що живе в пайплайні, а не в головах — а це також означає, що новий інженер може зарелізити першого тижня без того, щоб за ним хтось стояв.
Обрав Будувати синхронізацію 500K на добу під збої з самого початку — ідемпотентно, з повторами, стійко до запізнілих і дубльованих даних замість вважати сторонні інтеграції надійними й обробляти винятки, коли вони зʼявляться
На такому обсязі кожен режим збою трапляється щодня, включно з тими, що виглядають теоретичними. Проєктувати під повтори й запізнення одразу дешевше, ніж звіряти фінансовий набір даних, який тихо розійшовся, бо провайдер надіслав той самий запис двічі.
Що я зробив
Я підтягнув те, як вносяться зміни, а не те, з чого вони зроблені. Стандарти рев'ю, за якими щось стоїть — нічого не зливається без перегляду. Автотести, спрямовані спершу на шляхи, що рухають гроші: платежі, сторонні фінансові інтеграції, перевірки прав, які вирішують, хто може бачити дані клієнта. Процес релізу, однаковий кожного разу, замість уважної людини, що пам'ятає кроки.
Під цим — робота, з якої власне й тиснуло: синхронізація даних на 500 000+ записів на добу через інтеграції зі Stripe, Xplan, Google і AWS, побудована на припущенні, що будь-яка з них може впасти, повторитися або прийти із запізненням. Такого не беруться робити на кодовій базі, де не довіряєш власній вчорашній зміні — тому процес ішов першим.
Результат
Кількість багів упала приблизно на 30%, а цикли постачання скоротилися — і саме друге людей дивує, бо підтягування процесу звучить як додавання тертя. Насправді навпаки: більшість старого часу циклу йшла на перевірку руками, очікування, коли звільниться хтось сеньйорний, і виправлення того, що зламав попередній реліз.
Платформа витримала синхронізацію 500K на добу й інтеграції, що прийшли з нею. Я пробув на цьому акаунті чотири роки, виріс від розробника до Tech Lead, і та сама команда продовжила роботу після придбання Steelkiwi — код пережив угоду, за якої його писали, а це єдина надійна перевірка такої роботи.
Озираючись назад
Я не зняв базові показники. Ті 30% реконструйовані після факту, з кількості задач та історії релізів, а не зміряні від точки, яку я свідомо зафіксував, — і це слабше твердження, ніж мало би бути. Тиждень роботи на початку, щоб записати кількість багів, час циклу та кількість інцидентів, перетворив би всю цю роботу з історії на доказ.
Тепер я вважаю цей перший тиждень частиною роботи, а не прелюдією до неї. Якщо ви не можете сказати, яким число було до вашого приходу, ви не можете довести, що змінили, — а в такій роботі саме доказ і є тим, що клієнт купує.